Datum: 8-11-2026
Cybersecurity
Je AI-agent is veilig, de repository die hij aanraadt niet
Duizenden GitHub-repositories doen zich voor als AI-skills en MCP-servers. Het skill-bestand is schoon, de aanval zit in de README. In tests vonden Claude Code, ChatGPT en Gemini ze zelf en gaven ze de installatie door. Wat er wél en niet is aangetoond, en wie bij jou bepaalt wat de agent mag installeren.
TL;DROnderzoekers vonden duizenden GitHub-repositories die zich voordoen als AI-skills en MCP-servers. Het skill-bestand is schoon; de aanval zit in de README, die je naar een ZIP met een infostealer stuurt. In tests vonden Claude Code, ChatGPT en Gemini zulke repositories zelf en gaven ze de installatie-instructies door. Geen agent voerde iets uit. Het besluit dat ontbreekt: wie bepaalt wat jouw agent mag installeren. |
Een ontwikkelaar vraagt zijn AI-agent om een skill te zoeken. De agent zoekt, vindt een GitHub-repository met een verzorgde README en een duidelijke installatie-instructie, en geeft die door. De repository is van een aanvaller. De agent heeft niets gedaan wat je hem kunt verwijten: hij heeft gezocht, gelezen en samengevat. Dat is precies waar je hem voor hebt aangezet.
Het model is niet gecompromitteerd. Je promptbeveiliging heeft niet gefaald. Er is geen prompt injection aan te pas gekomen. Wat er gebeurde is dat iemand de documentatie heeft geschreven die jouw agent zou gaan lezen.
Wat er precies gemeld is, en wat niet
Op 20 juli 2026 publiceerde Island-onderzoeker Oleg Zaytsev een analyse van een campagne die FakeGit wordt genoemd: ongeveer 7.600 kwaadaardige GitHub-repositories, aangemaakt vanaf ongeveer 6.600 profielen. Daarvan raken er ongeveer 1.400 aan AI-tools, agents of workflows, en ruim 800 doen zich specifiek voor als Skills of MCP-servers. De AI-golf bouwde op in maart en piekte in april 2026, met bijna 300 nieuwe AI-repositories in die ene maand.
Op 8 oktober meldde Apiiro dat de campagne op 4 oktober weer op gang kwam, nu met 17.610 repositories. Ruim 13.000 daarvan werden in 34 uur gepusht, met een piek van 2.999 per uur. Van de bemonsterde commits raakte 97 procent alleen de README, en wees 88 procent de Download-knop naar een ZIP die SmartLoader installeert. Er hoefde geen enkele nieuwe repository te worden aangemaakt: de vloot lag er al en werd opnieuw gericht.
Begin november kwam het onderwerp opnieuw voorbij via een bericht van onderzoeker Thomas Roccia over 73 repositories die zich voordeden als Claude-skills, Codex, MCP-servers en OpenClaw, waarvan er die ochtend nog 51 online stonden. Die aantallen heb ik niet onafhankelijk kunnen bevestigen; het blijft één melding van één onderzoeker. Wat ik wel kan bevestigen is het mechanisme dat hij beschrijft, want dat staat identiek in het onderzoek van Island.
Eén getal verdient een waarschuwing, omdat het overal verkeerd wordt overgenomen. Island mat ruim 14 miljoen downloads van release-bestanden in zo'n 200 campagnerepositories. Zaytsev zegt er zelf bij dat daar herhaalde requests en geautomatiseerd verkeer in zitten en dat het niet als besmettingen gelezen mag worden. Wie het als besmettingscijfer presenteert, verkoopt je iets.
De aanval zat niet in het model
Een AI-agent die software kan installeren en commando's kan uitvoeren, vertrouwt niet één ding. Hij vertrouwt er vijf, en die staan los van elkaar:
- Het model. Of het doet wat je vraagt en weigert wat het hoort te weigeren.
- De instructies. De systeemprompt, de skill-definitie, de regels die jij hem meegeeft.
- De repository. De plek waar hij de capability vandaan haalt.
- De software. Wat daar daadwerkelijk uit komt en wat dat doet.
- De omgeving. Welke rechten, sessies en sleutels binnen handbereik liggen als het draait.
De meeste AI-beveiliging van het afgelopen jaar ging over de eerste twee. Jailbreaks, prompt injection, guardrails, evaluaties. Deze campagne raakt geen van beide. Een model dat correct weigert om malware te schrijven, leest probleemloos een README en vat de installatiestappen samen, want documentatie lezen en samenvatten is geen aanval, het is de opdracht.
Dat onderscheid bepaalt welke maatregel werkt. Tegen prompt injection help je met filtering. Hiertegen help je met een lijst van wat erin mag, en met een omgeving waarin een foute installatie niet meteen bij je productiesleutels kan.
Van README naar werkstation
De keten is onopvallend, en dat is het punt. Island beschrijft een concreet voorbeeld: een repository die zich voordoet als MCP-server voor Databricks, met een README die belooft 263 Databricks-tools te ontsluiten. De knop "Download Latest Release" wijst naar een ZIP die gewoon in de repository staat. De instructie zegt: downloaden, uitpakken, uitvoeren.
In die ZIP zitten drie bestanden. Een starter, application.cmd, met één regel erin: start de tweede. De tweede is luau.exe, door Island omschreven als een hernoemde Lua-runtime. De derde is ico64.txt: ongeveer 300 kilobyte zwaar versluierd Lua-programma, op één regel. Een tekstbestand dat geen tekstbestand is. De namen verschillen per repository, de structuur niet: een starter, een runtime, en een payload vermomd als tekst-, icoon-, licentie- of databestand.
Voor wat daarna gebeurt leunt Island op analyse van andere samples door Derp.ca: het consolevenster wordt verborgen, het adres van de commandoserver wordt opgehaald uit een waarde in een smartcontract op Polygon, persistentie komt via een geplande taak, en versleutelde vervolgstadia worden van GitHub gehaald. Aan het eind staat StealC. De IOC's staan publiek.
Wat StealC meeneemt is de reden dat dit een bestuurskwestie is en geen werkplekincident: browserwachtwoorden, cookies, actieve sessies, data van browserextensies, e-mail- en remote-access-inloggegevens, schermafbeeldingen en hostinformatie. Let op die actieve sessies. Een gestolen sessiecookie is al voorbij je multifactor-authenticatie. Wachtwoorden resetten is daarom niet genoeg; je moet sessies, OAuth-toestemmingen, API-tokens en cloud- en ontwikkelaarsinloggegevens intrekken.
Voor wie dit in detectieregels wil hangen: uitvoering door de gebruiker zelf (T1204.002), een payload vermomd als onschuldig bestandstype (T1036), persistentie via een geplande taak (T1053.005) en diefstal van actieve websessies (T1539).
Een vermelding in een register is geen keurmerk
Island vond ruim 600 vermeldingen van campagnerepositories in publieke catalogi voor skills en MCP-servers: LobeHub, Glama, MCP.so en MCP Market. Of die vermeldingen handmatig zijn ingediend of automatisch zijn geïndexeerd, konden de onderzoekers niet vaststellen. Voor jou maakt dat niet uit. De conclusie is hetzelfde: dat iets in een catalogus staat, zegt niets over wie het heeft gepubliceerd.
De signalen waren er wel, als iemand gekeken had. Het originele project dat werd nagemaakt heeft ruim 67.000 sterren en 7.600 forks. De nagemaakte kopie had 63 sterren en 18 forks. Dat verschil ziet een mens in twee seconden, maar alleen als hij op de pagina kijkt in plaats van op de samenvatting ervan. Een agent die een README leest en doorgeeft, telt geen sterren. Een ontwikkelaar die om 16:40 een plugin wil laten werken, ook niet.
De lokkertjes waren op jouw omgeving geschreven
Dit is het deel dat het van een IT-probleem naar een bestuursprobleem tilt. Island deelde de kwaadaardige Skill- en MCP-repositories in naar het onderwerp waarmee ze lokten:
- 62 procent was gepositioneerd voor zakelijk of intern ontwikkelgebruik.
- Ongeveer een derde ging over operationele bedrijfsdata.
- Ongeveer een kwart ging over broncode.
- Ongeveer één op de zes ging over inloggegevens of secrets.
- Bijna twee derde van de MCP-repositories werd gepresenteerd als connector voor clouddiensten, databases of API's.
Dit is dus geen consumentenmalware die toevallig op een werklaptop belandt. De teksten zijn geschreven voor de persoon die toegang heeft tot productie. Wie een MCP-connector zoekt voor zijn datawarehouse, is per definitie iemand met inloggegevens voor dat datawarehouse. Dat is geen toeval in de campagne; dat is het ontwerp.
Het besluit dat niemand heeft genomen
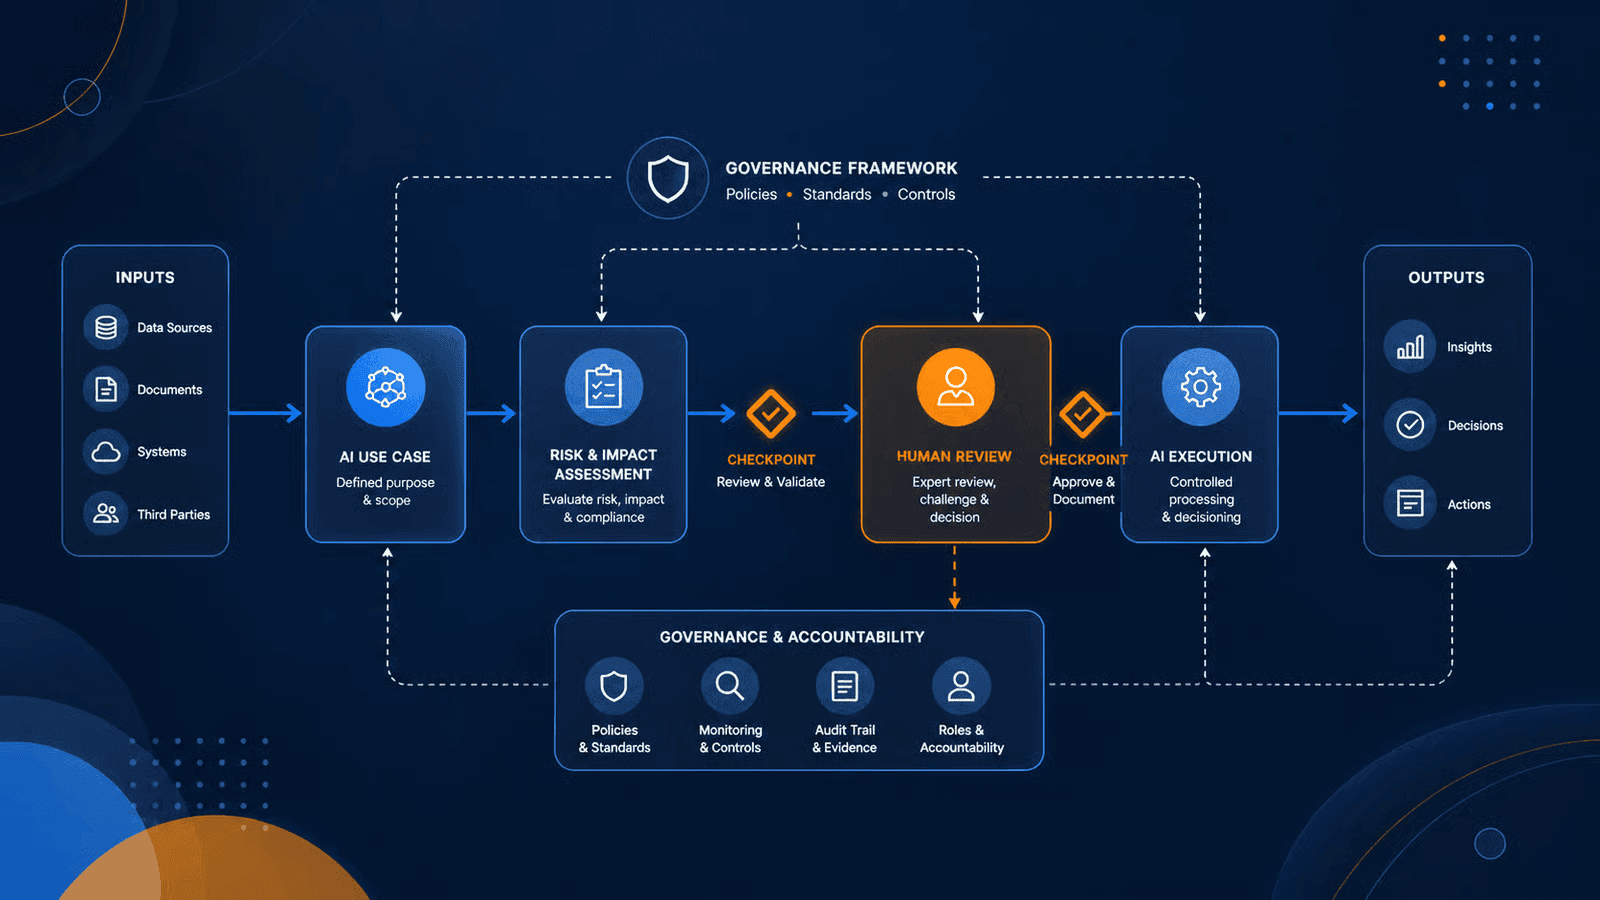
Stel de vraag eens hardop in je eigen organisatie: welke AI-skills en MCP-servers draaien er op dit moment, geïnstalleerd door wie, uit welke repository, op welke commit? In de meeste organisaties is het antwoord daarop niet "dat weten we niet precies" maar "dat registreren we nergens". Dat is een ander probleem, en een groter.
Want zonder dat register kun je de vervolgvragen ook niet beantwoorden. Erven je agents de inloggegevens van de ontwikkelaar? Kunnen ze bij productie? Wordt vastgelegd wat ze hebben gedownload en uitgevoerd? Kan iemand een agent stilzetten zonder de hele ontwikkelstraat plat te leggen? Dekt je incidentresponsplan een gecompromitteerde AI-tool? Het begint allemaal bij een inventaris, en dat is precies de stap die wordt overgeslagen omdat hij saai is.
ISO/IEC 42001 en het NIST AI Risk Management Framework vragen allebei dat je je AI-middelen kent en je leveranciers beoordeelt. Geen van beide schrijft voor hoe je een MCP-server goedkeurt of wie dat mag. Dat is geen tekortkoming van die kaders, het is het stuk dat jij zelf moet invullen, en het is precies het stuk waar het beleid op papier en de werkelijkheid op het werkstation uit elkaar lopen.
Wat je deze week doet
Vier dingen, op volgorde van wat het snelst iets oplevert.
- Maak de inventaris. Welke agents draaien er, met welke skills en MCP-servers, geïnstalleerd door wie, uit welke repository, op welke commit of hash. Zonder dit is de rest giswerk.
- Voer één regel in. Een AI-capability die zich installeert via een gedownload uitvoerbaar bestand, gaat er niet in. Een echte MCP-server of skill is broncode met een manifest, geen Windows-ZIP met een starter en een runtime. Deze regel is vandaag in te voeren en had deze hele campagne tegengehouden.
- Zoek terug. Downloads van ZIP-bestanden vanaf GitHub op ontwikkelwerkstations, en processen die een runtime starten met een tekst-, icoon- of databestand als argument. Dat laatste patroon is zeldzaam genoeg om als detectieregel te dienen.
- Kijk naar de rechten. Welke inloggegevens erft een agent van de ontwikkelaar die hem start, en kan hij daarmee bij productie? Dit is de vraag die bepaalt of een fout installatiemoment een incident wordt of een voetnoot.
Daarna, en dat kost wel een kwartaal: een goedgekeurde catalogus van skills en MCP-servers; vastpinnen op commit of hash in plaats van op "latest"; elke nieuwe capability eerst in een geïsoleerde omgeving zonder browsersessies, cloudsleutels, SSH-sleutels of productiedata; en logging van wat de agent zelf initieert, downloads, clones, shell-commando's, wijzigingen in skill-mappen en MCP-configuratie. Dat laatste is de enige manier waarop je over een half jaar nog kunt reconstrueren wat er is gebeurd.
Niet alles hiervan is voor iedereen even urgent. Draaien je agents alleen read-only tegen een testomgeving, dan is de catalogus belangrijker dan de sandbox. Hebben ze shell-toegang op een werkstation met cloudsleutels, dan is het andersom.
Het besluit om 08:15
Het volgende is een hypothetisch scenario, geen incident bij een klant.
Om 08:15 ziet Security dat een ontwikkelaar gisteren een MCP-server heeft geïnstalleerd uit een repository die vannacht op een IOC-lijst is beland. Het werkstation had toegang tot broncode, interne repositories en cloudsleutels. Er is geen bewijs van exfiltratie. Er is ook geen bewijs dat het niet gebeurd is, want wat de agent heeft gedownload en uitgevoerd, is niet gelogd.
Nu moet iemand kiezen. Werkstation isoleren en alle sessies en tokens van die ontwikkelaar intrekken, of eerst onderzoeken. Intrekken betekent dat een team een halve dag stilligt en dat het incident zichtbaar wordt in de hele organisatie. Wachten betekent een paar uur extra waarin een eventueel gestolen sessiecookie nog geldig is.
De interessante vraag is niet welke keuze de juiste is. Dat hangt af van wat er op dat werkstation stond. De interessante vraag is wie die keuze om 08:15 mag maken, vóórdat het onderzoek rond is. Als het antwoord is dat daar eerst overleg voor nodig is met drie mensen die nog niet wakker zijn, dan heb je het antwoord al, en dan is dat het eerste dat je repareert, nog vóór de catalogus.
Tot slot
Het ongemakkelijke aan deze campagne is niet dat hij geraffineerd is. Hij is het tegenovergestelde van geraffineerd: een ZIP met drie bestanden en een README die je vraagt op "toch uitvoeren" te klikken. Hij werkt omdat hij een laag raakt waar niemand eigenaar van is.
Je hebt je model gekozen. Je hebt waarschijnlijk een AI-beleid liggen. De vraag die daar meestal niet in staat: welke repositories mag je agent vertrouwen, wie heeft dat bepaald, en kun je morgen nog reconstrueren wat hij gisteren heeft uitgevoerd?
Veelgestelde vragen
Is ons AI-model hiermee gecompromitteerd?
Nee. Er is geen aanwijzing dat een model, een modelgewicht of een modelleverancier is geraakt. De aanval zit in de software die een agent vindt en aanraadt, niet in de agent zelf. Dat is ook waarom modelgerichte maatregelen hier niets tegen doen.
Heeft een AI-agent dit zelf geïnstalleerd en uitgevoerd?
In wat er gepubliceerd is: nee. In de tests van Island gaf Claude Code in één run de instructies uit een kwaadaardige README door aan de gebruiker, terwijl hij in andere runs de inhoud wél verdacht vond en de repository afraadde. Volgens de verslaglegging bij BleepingComputer kloonde Claude Code in een gecontroleerde test een kwaadaardige repository en downloadde hij de bestanden, maar stopte hij voor uitvoering. ChatGPT en Gemini raadden kwaadaardige repositories aan zonder dat ze een link kregen. Er is geen gedocumenteerd geval in het wild waarin een agent de payload zelf heeft uitgevoerd. Dat onderscheid is belangrijk genoeg om niet te laten verwateren.
Zijn die 14 miljoen downloads 14 miljoen besmettingen?
Nee, en de onderzoeker die het getal heeft gemeten zegt dat er zelf bij. Het gaat om downloadtellers van GitHub, inclusief herhaalde requests en geautomatiseerd verkeer. Het zegt iets over de schaal van de campagne en niets over het aantal slachtoffers.
Is het genoeg om het skill-bestand te controleren?
Nee, en dat is de kern. In de gedocumenteerde gevallen is het skill- of configuratiebestand schoon; de aanval zit in de README en in een ZIP die in dezelfde repository staat. Wie alleen de manifestbestanden scant, scant precies het deel dat niet kwaadaardig is. Je moet naar alles kijken wat er in de repository meekomt, naar wie hem publiceert en naar de commitgeschiedenis.
Beschermt multifactor-authenticatie hiertegen?
Tegen de initiële installatie niet, en tegen het gevolg maar deels. StealC steelt naast wachtwoorden ook cookies en actieve sessies, en een gestolen sessie is al langs de multifactor-stap. Daarom is intrekken van sessies, OAuth-toestemmingen en tokens bij een vermoeden belangrijker dan een wachtwoordreset.
Speelt dit alleen op Windows?
De beschreven keten is Windows-specifiek: een .cmd-starter, een .exe-runtime en de melding "Windows heeft uw pc beschermd" die je moet wegklikken. Dat zegt niets over andere campagnes, en het onderliggende probleem is niet platformgebonden: een agent die een README vertrouwt, doet dat op elk besturingssysteem.
Verder lezen
- Island: AgentBaiting, hoe nagemaakte AI-skills en MCP-servers malware afleverden (20 juli 2026)
- Island: de IOC's van deze campagne
- BleepingComputer: FakeGit gebruikt 7.600 GitHub-repositories voor SmartLoader (21 juli 2026)
- BleepingComputer: FakeGit terug met 17.610 repositories (8 oktober 2026)
- Apiiro: het onderzoek achter de oktobergolf
- CyberBusters: AI-inventaris, use cases, autonomie en datastromen
- CyberBusters: AI-governance en ISO/IEC 42001